

有关使用Python中的Surprise库实现kNN风格推荐引擎的分步指南,从数据准备到预测。
> Photo by Hanh Nguyen on Unsplash
啊,我们舒适的现代生活中令人难以忍受的痛苦,所有的纸杯蛋糕看起来都很诱人,但是您无法尝试所有的纸杯蛋糕,那么您应该吃哪一个? 无论使用哪种平台,您的选择通常实际上都是无限的,但是作为消费者的资源却并非如此。 不用担心,推荐系统可以助您一臂之力!
框架推荐系统是我们有一组用户和一组项目,对于给定的用户,我们希望过滤到相关用户将喜欢的项目子集(高价,购买,观看等),具体取决于 在确切的问题上)的可能性很高。 推荐系统无处不在,所有基于内容的非常成功的科技公司,例如Netflix,Amazon,Facebook,都非常依赖复杂的推荐系统来增加其产品的消费量。
在作为本文基础的特定项目中,我专注于boardgamegeek(截至2020年3月31日)的前100个游戏,并与我从网站上收集的230万个人用户评分进行了合作。 我主要使用Surprise,Python scikit库专注于推荐系统,其结构与scikit-learn非常相似。
在本文中,我们将讨论基于内存的模型。 我们将讨论如何导入和准备数据,要使用哪些相似性度量,如何实现三个内置的kNN模型,如何应用模型验证以及最终做出预测。 有关此项目的详细信息,请参阅我的GitHub存储库,我们将在本文中介绍的工作大致对应于文件02_modelling_neighbours.ipynb中的代码。
目录
推荐系统数据导入数据准备模型参数KNN模型测试预测交叉验证将其放在一起可能的改进
推荐系统
让我们先快速介绍一下推荐系统系列,以便我们可以放置最近的邻居模型。
您可以采用两种主要的推荐路线:
· 基于内容的过滤模型基于商品的描述和用户的历史偏好,我们不需要其他用户的意见即可推荐。 示例:用户喜欢VlaadaChvátil设计的三款游戏,因此我们推荐他设计的第四款游戏。
· 协作过滤模型试图通过共同评价/拥有的项目来查找项目/用户之间的相似性。 示例:用户喜欢Caverna,从对人群的分析中我们知道,那些喜欢Caverna并了解Fdin for Odin的用户也往往喜欢第二款游戏,因此我们向用户推荐FfO。
在这个项目中,我们将进行协作过滤。 在协作过滤组中,两种最著名的独特方法是:
· 基于内存的模型会根据用户项目评分对计算用户/项目之间的相似度。
· 基于模型的模型(不可思议的名称)使用某种机器学习算法来估计评分。 一个典型的例子是用户项评级矩阵的奇异值分解。
在本文中,我们将重点介绍基于内存的模型。 因此,再次,内部推荐系统是协作过滤,而内部协作过滤是基于内存的模型。
资料汇入
首先,我们需要安装Surprise软件包:
pip install scikit-surprise
完成后,您需要一个数据集,其中包含三个变量:用户ID,项目ID和等级。 这很重要,请勿尝试以用户项评分矩阵格式传递评分。 从具有3列且行数等于各个额定值总数的数据开始。
如果您只是想练习,请随时使用我的GitHub上的数据集。 我个人将它们收集在csv文件的三列中,但是您也可以使用其他数据结构,也可以直接从pandas DataFrame加载。
为了导入数据,您需要从库中获取以下类:
from surprise import Dataset, Reader
然后定义file_path(显然更改为您的文件):
file_path = './data_input/games_100_summary_w_testuser.csv'
最后,我们创建一个具有以下属性的Reader对象:
· line_format:确保订单与您的文件匹配。
· sep:如果我们使用的是csv,这是一个逗号。
· rating_scale:具有最低和最高范围的元组。 正确设置此参数很重要,否则部分数据将被忽略。 例如,如果您使用的是二进制数据,那么用户是否喜欢/不喜欢该项目,则可以输入(0,1)。
reader = Reader( line_format='user item rating', sep=',', rating_scale = (1,10) )
要导入数据,请使用load_from_file方法:
data = Dataset.load_from_file(file_path, reader=reader)
就是这样,您应该以令人惊讶的格式使用您的数据! 您现在可以将数据想象成一个稀疏矩阵,其中用户/项是行/列,而各个等级是该矩阵中的元素。 大多数单元格可能为空,但这完全可以。 在我使用的数据中,我的评级为230万,用户数量约为23万,这意味着用户平均对100款游戏中的10款进行了评级,因此矩阵中有90%的用户为空。
资料准备
这是令人惊讶的首先使用的地方,它的工作过程与scikit-learn中的分类器模型不同,在该模型中,您有一个大矩阵,您可以将其拆分为训练/验证/测试集,然后进行交叉处理。 验证,但您认为合适,因为它们本质上仍是相同类型的数据。 不,令人惊讶的是,有三种不同的数据类,每种都有各自不同的用法:
· 数据集:用于直接或通过交叉验证迭代器拆分为训练集和测试集。 后者意味着如果您在交叉验证中将数据集作为参数传递,它将创建许多训练测试拆分。
· 训练集:在模型的拟合方法中用作参数。
· 测试集:用作模型测试方法中的参数。
在我看来,令人惊讶的是一个相对有据可查的图书馆,但是仍然有一些奇怪之处。 例如,数据集对象具有方法construct_testset,但是除了在文档页面的先前版本中查找代码外,没有解释其作用或参数应为什么。
我坚持在我的项目中有据可查的方法。 我们正在为两种不同的方法做准备,在以下各节中将更清楚地说明这些方法的目的。
我们将使用来自model_selection包的以下内容:
from surprise.model_selection import train_test_split
首先,我们将数据分为训练集和测试集,测试大小设置为20%:
trainset, testset = train_test_split(data, test_size=0.2)
再次,它与分类器/回归模型的工作方式略有不同,测试集包含随机选择的用户/项目评分,而不是完整的用户/项目。 一位用户的数据可能有10个评分,现在随机选择其中3个评分作为测试集,而不用用于拟合模型。 当我第一次注意到时,我发现这个奇怪的地方,但是完全不删除某些用户是很有意义的。
第二种方法是使用完整数据并交叉验证进行测试。 在这种情况下,我们可以通过build_full_trainset方法使用所有评级来构建Trainset对象:
trainsetfull = data.build_full_trainset()
您可以使用n_users和n_items方法获取项目数/用户数(trainsetfull可以使用相同的方法,因为它们是同一类型的对象):
print('Number of users: ', trainset.n_users, '\n')
print('Number of items: ', trainset.n_items, '\n')
当Surprise创建一个Trainset或Testset对象时,它将使用raw_id(您在导入的文件中使用的对象),并将它们转换为所谓的inner_id(基本上是一系列从0开始的整数)。 您可能需要追溯到原始名称。 以这些项目为例(您可以对用户执行相同的方法,只需在代码中将iid与uid交换即可),即可使用all_items方法来获取inner_iid的列表。 要将原始ID转换为内部ID,可以使用to_inner_iid方法,然后使用to_raw_iid进行转换。
有关如何保存内部项目ID和原始项目ID的列表的示例:
trainset_iids = list(trainset.all_items())
iid_converter = lambda x: trainset.to_raw_iid(x)
trainset_raw_iids = list(map(iid_converter, trainset_iids))
到此,我们的数据准备结束了,接下来是时候了解一些模型参数了!
型号参数
当我们使用kNN —类型推荐器算法时,可以调整两个超参数:k参数(是,与模型类型名称相同的k)和相似性选项。
k参数非常简单,类似于它在一般的k最近邻居模型中的工作方式:它是我们希望算法考虑的相似项的上限。 例如,如果用户为20个游戏评分,但我们将k设置为10,则当我们估算新游戏的评分时,将仅考虑20个游戏中最接近新游戏的10个游戏。 您也可以设置min_k,如果用户没有足够的评分,则将使用全球平均值进行估算。 默认情况下为1。
我们在上一段中提到了彼此接近的项目,但是我们如何确定该距离呢? 第二个超参数(相似性选项)定义了计算它的方式。
首先让我们看一下sim_option配置。 此参数是字典,具有以下键:
· 收缩:不需要基本的kNN模型,只需与KNNBaseline模型一起使用即可。
· user_based:基本上,当您要估算相似性时,有两种不同的路线。 您可以计算每个项目与其他项目的相似程度,也可以计算用户的相似程度。 对于我的项目,考虑到我有100个项目和23万个用户,我使用False。
· 名称:公式的类型,将在下面进一步讨论。
所有相似性函数都会向特定(i,j)项目对返回0到1之间的数字。 1表示评级完全一致,0表示两项之间没有任何联系。 在公式中,r??是u对项目i给予的评价用户,μ?是对i项进行平均评价,而U??是对i和j都进行评价的用户集合。 这些是惊奇相似性模块中的三个相似性度量:
余弦:
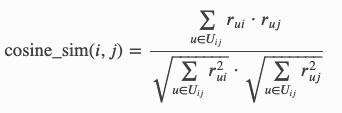
MSD:
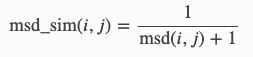
其中msd(i,j)为:
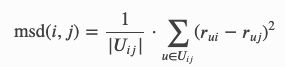
皮尔逊:
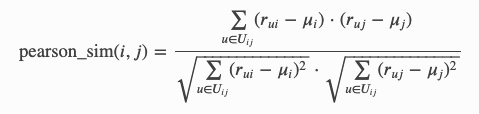
尽管我很少看到示例中使用MSD,但没有明确的好坏选择,而且在我的数据中,Pearson和余弦的性能确实好得多。 可以看到,皮尔逊公式基本上是余弦公式的均值中心形式。
有关如何定义sim_option参数的示例:
my_sim_option = { 'name':'MSD', 'user_based':False, min_support = 1 }
现在我们做了所有准备工作,终于可以训练一些模型了。
KNN模型
基本的KNN模型有三种变化,这令人惊讶(我们在本文中不考虑第四种,即KNNBaseline)。 他们定义了如何在预测中估算用户i对项目i的评级。 下面的公式主要使用我们在上一节中讨论过的符号,其中有两个是新的:σ?是项目i的标准偏差,N??(i)是来自与您所评级最接近的项目i的用户最多k个项目 。
事不宜迟,公式如下:
KNN基础:
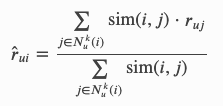
估算的评分基本上是用户对相似项目评分的加权平均值,并由相似度加权。
KNNWithMeans:
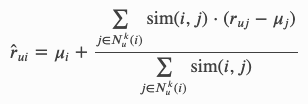
使用项目的平均评分调整KNNBasic公式。
KNNWithZScore:
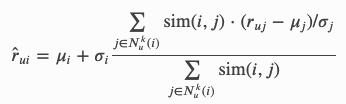
更进一步,还根据额定值的标准偏差进行调整。
在下面的示例中,我们使用三个my_参数拟合KNNWithMeans模型。 根据我的经验,如果您的商品的平均评分不同,几乎就不会选择使用KNNBasic。 您可以根据需要自由更改这些参数,并且所有三个模型都使用完全相同的参数。 您可以在下面的代码中将KNNWithMeans更改为KNNBasic或KNNWithZScore,它的工作原理相同。
from surprise import KNNWithMeans
my_k = 15
my_min_k = 5
my_sim_option = { 'name':'pearson', 'user_based':False, }
algo = KNNWithMeans( k = my_k, min_k = my_min_k, sim_option = my_sim_option )
algo.fit(trainset)
这样,我们的模型就很合适了。 从技术上讲,这时发生的所有事情是模型选择了相似度矩阵和均值/标准差。
您可以使用sim方法请求相似性矩阵,如下所示:
algo.sim()
它将为numpy数组格式。 除非您想自己进行某种预测,否则可能不需要此矩阵。
测试中
训练模型后,就该进行测试了吧? 性能指标保存在意外的准确性模块中。 这里有四个指标(RMSE,FCP,MAE,MSE),但是据我所知,行业标准是均方根误差,因此我们仅使用该指标。 这是我们今天的最终数学公式:
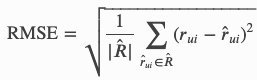
该分数大致告诉您估计的平均评分与实际的平均评分之间的差距。 要获得测试分数,您要做的就是使用已经适合的算法上的测试方法创建一个预测对象:
from surprise import accuracy
predictions = algo.test(testset)
accuracy.rmse(predictions)
假设根据我的数据,测试数据的RMSE得分为1.2891。 这意味着估计的收视率平均比实际收视率高1到10倍左右或低1到10分。 不好,不可怕。
交叉验证
在前两节中,我们采用了非常直接的方法:我们保留测试数据,训练模型,然后测试其性能。 但是,如果您进行多次运行,则最好使用交叉验证来测试模型的性能以及模型是否过拟合。
如前所述,测试和验证的效果有些不同。 您只能对原始数据集对象进行交叉验证,而不能为最终测试留出单独的测试部分,至少我找不到解决方法。 所以我的过程本质上是这样的:
· 对具有不同参数的多种模型类型进行交叉验证,
· 选择平均测试RMSE得分最低的配置,
· 在整个数据集上训练了该模型,
· 用它来预测。
让我们讨论cross_validate方法的几个参数:
· cv是我们定义模型要使用的折叠类型的地方,类似于scikit-learn中的工作方式。 我将通过输入整数来使用基本的K折,您可以在文档中了解不同的K折。
· n_jobs:并行评估的折叠数,如果您可以节省内存,则将其设置为-1将意味着所有CPU都在并行工作。 但是,当我在本地计算机上执行此操作时,它崩溃了。 我最终将其保留为默认值1。
在下一部分中,我们将交叉验证的结果保存在result变量中:
from surprise.model_selection import cross_validate
results = cross_validate( algo = algo, data = data, measures=['RMSE'], cv=5, return_train_measures=True )
请注意,运行此操作可能需要几分钟,测试需要一段时间,而交叉验证则需要执行5次。
完成后,您可以深入结果变量以分析性能。 例如,要获得平均测试RMSE:
results['test_rmse'].mean()
自然,您会花一会儿时间,然后尝试不同的模型,并力争降低RMSE得分。 对性能满意并创建了满意的算法模型后,就可以在整个数据集上训练算法了。 您需要执行此步骤,因为正如我提到的那样,您无法根据交叉验证做出预测。 与上面针对非完整训练集所做的代码相同:
神奇的工作室algo.fit(trainsetfull)
下一步,我们继续进行预测!
预测
最后,这就是为什么我们做了整个项目,对吧? 关于惊喜的两个重要说明可能与您的期望不符:
· 只能对已经在数据集中的用户进行预测。 这也是为什么我认为在流程结束时在整个数据上训练模型才有意义的原因。
· 您无法直接从模型中获得输出列表,只需调用一次,您就可以要求一个特定用户对某个特定项目的估算等级。 但是,有一种解决方法,我们稍后会再讨论。
为了进行一次预测,您可以使用原始ID,因此要获取TestUser1(数据中至少具有min_k个其他评分的用户)ID为161936的游戏的估算评分,您需要使用自己的预测方法 经过训练的算法:
algo.predict(uid = 'TestUser1', iid = '161936')
预测方法将返回如下字典:
Prediction(uid='TestUser1', iid='161936', r_ui=None, est=6.647051644687803, details={'actual_k': 4, 'was_impossible': False})
r_ui为None,因为用户对该项目没有实际评分。 这是我们最终最感兴趣的项目,即估计的等级,在我们的案例中,我们估计等级为6.神奇的工作室647。
这样很好,但是我们如何为用户获得前N条推荐呢? 您可以在文档中找到一个详细的解决方案,我不会在此处复制它们,这些是基本步骤:
· 在trainsetfull上的训练模型。
· 使用build_anti_testset方法创建一个" anti testset"。 这基本上是我们原始数据集的补充。 因此,如果用户对100款游戏中的15款进行了评分,则我们的测试集将包含该用户未评分的85款游戏。
· 使用测试方法在anti_testset上运行预测(结果与预测方法类似)。 通过此步骤,我们为数据中缺少的所有用户项评级对提供了估计评级。
· 对每个用户的估计评分进行排序,列出N个具有最高估计评分的项目。
放在一起
我认为将我们讨论的内容连续包含在内是很有意义的。 我们在下面的代码中采用的方法是交叉验证路线,因此我们使用交叉验证测试性能,然后将模型拟合到整个数据集。
请注意,您极有可能不会止步一次交叉验证,而应尝试其他模型,直到找到最佳模型。 您可能还希望促进上一节中链接的前N条建议。
附加步骤
当您遇到令人惊讶的工作时,还有许多其他选择,我打算在以后的博文中进行探讨。
相当明显的下一步是使用SVD和SVDpp方法探索基于模型的方法。 这些在估计等级中使用矩阵分解。 另外,您可能已经注意到,在这种情况下,我没有使用GridSearchCV进行超参数调整。 考虑到我们只有几个参数,我发现使用cross_validate就足够了,但是当涉及到更复杂的模型时,您肯定要使用GridSearchCV。
另一个值得探索的领域是预测。 有时,您只想对某些用户评级运行模型,而无需将其集成到基础数据库中。 例如,我从boardgamegeek收集了数据,当我只想快速向某人展示该模型时,我不希望这些评分与"官方"评分混在一起。 为一个用户重新运行整个模型也不是很有效。 现在,对于我们讨论的三种KNN模型,完全有可能仅根据相似性矩阵,均值和标准差进行预测。 我将在以后的文章中专门介绍该过程,或者您可以在GitHub中查看recomm_func.py脚本。
(本文翻译自Mate Pocs的文章《How to Build a Memory-Based Recommendation System using Python Surprise》,参考:https://towardsdatascience.com/how-to-build-a-memory-based-recommendation-system-using-python-surprise-55f3257b2cf4)